Ce que l’API Instagram permet vraiment en recherche
Une API REST de recherche classique accepte une requête et interroge un vaste index. Les interfaces officielles d’Instagram fonctionnent autrement. Meta expose des edges spécifiques pour des cas d’usage approuvés, généralement dans le contexte d’un compte Business ou Creator autorisé, plutôt qu’un index sans restriction des objets publics d’Instagram. La référence IG User de l’API Graph Instagram documente l’accès aux hashtags qu’un utilisateur Instagram a recherchés au cours des 7 derniers jours, tandis que le flux hashtag résout un hashtag puis récupère les médias qui y sont associés.
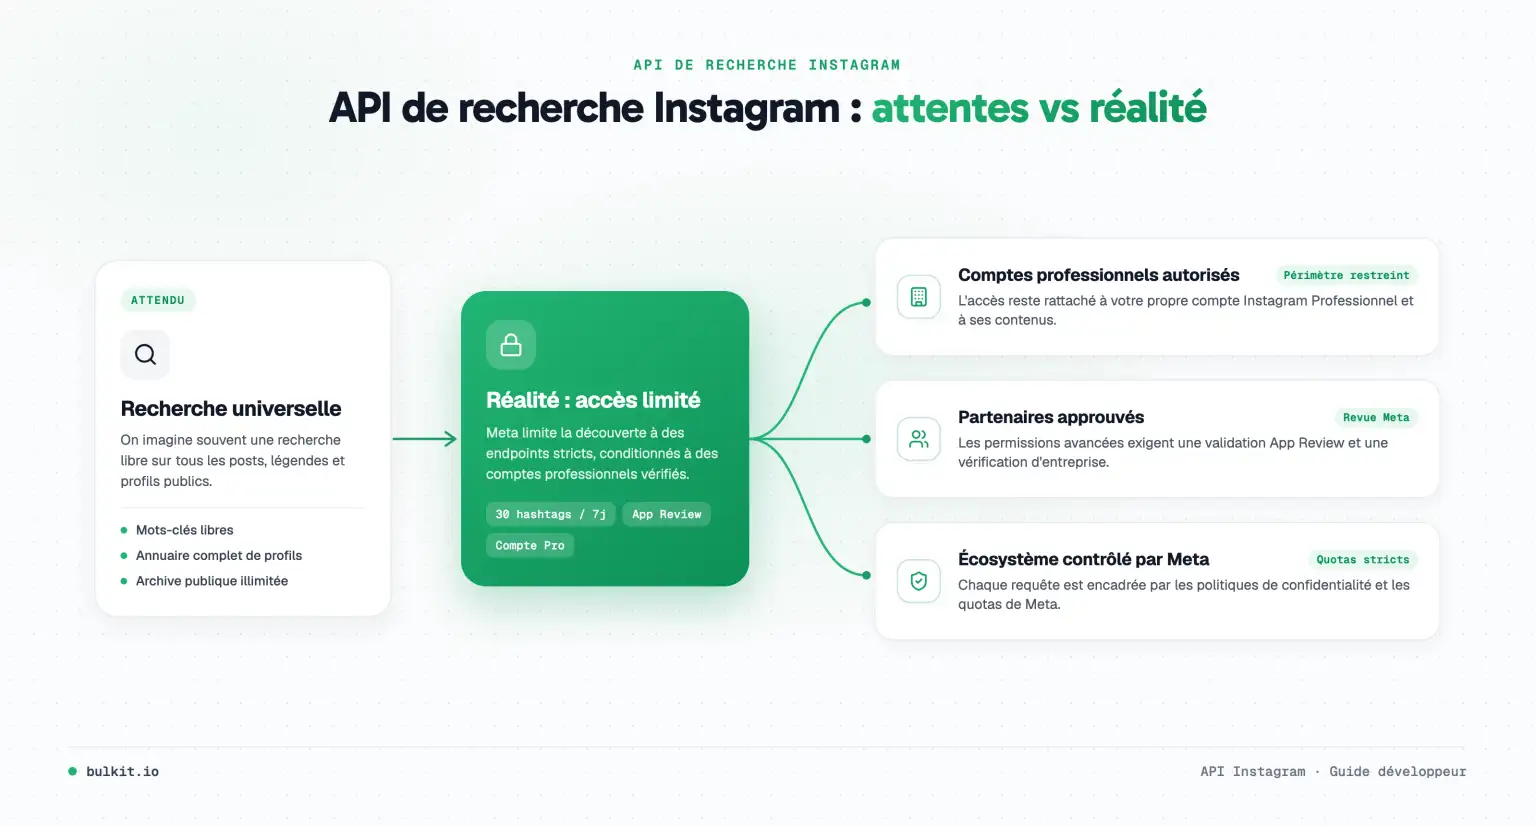
Autrement dit, la recherche arbitraire d’utilisateurs publics et la recherche générale par mots-clés sur l’ensemble du contenu public ne sont pas disponibles via la surface officielle décrite dans la documentation actuelle de Meta. L’API est fondée sur des edges : chaque relation prise en charge a son propre endpoint, ses propres permissions et son propre modèle de réponse. Elle est aussi liée au compte : le rôle du compte authentifié et l’identité Instagram connectée déterminent ce que l’application peut demander.
La frontière qui façonne la conception produit
Commencez par rédiger une matrice des capacités avant de construire un écran de recherche :
- Découverte par hashtag : résoudre l’ID d’un hashtag, puis demander les médias populaires ou récents pour ce hashtag.
- Historique de recherche du compte : lire les hashtags uniques recherchés par le compte Business ou Creator autorisé via l’edge utilisateur documenté.
- Recherche universelle par mots-clés : pas une capacité officielle à usage général.
- Découverte arbitraire d’utilisateurs publics : pas une surface de recherche ouverte officielle.
Cette frontière compte davantage qu’un contournement de rate limit. Si une exigence suppose de trouver tous les créateurs correspondant à une expression, l’équipe doit modifier l’exigence, combiner des sources autorisées ou renoncer à promettre cette fonctionnalité. Le scraping de surfaces privées ou non documentées n’est pas un substitut stable à une intégration approuvée, et il introduit des risques de conformité et de maintenance.
La politique de confidentialité de Bulkit est également pertinente dès qu’une application stocke des données de comptes connectés, un historique de recherche, des métadonnées de médias ou des analyses dérivées. Définissez la conservation, la suppression et le comportement à la déconnexion d’un compte avant la première connexion en production, pas après un audit de conformité.
Règle pratique : considérez la recherche Instagram comme un ensemble d’objets et d’edges étroitement définis, pas comme un index universel caché.
Le flux hashtag pris en charge suit volontairement deux étapes. Vous n’envoyez pas une chaîne de hashtag directement à un endpoint de médias en espérant qu’Instagram l’interprète. Votre application résout d’abord le hashtag en un ID de hashtag Instagram. Elle utilise ensuite cet ID pour récupérer les médias.
Étape 1 : résoudre le hashtag
Appelez GET /ig_hashtag_search dans le contexte d’un compte Instagram Business ou Creator autorisé. La requête nécessite le token d’accès adéquat, le contexte du compte et le texte du hashtag à résoudre. La documentation officielle de la recherche de hashtags décrit cette étape de résolution d’ID et les exigences de compte qui l’entourent.
Un flux de requête conceptuel ressemble à ceci :
- Envoyer le texte du hashtag à
GET /ig_hashtag_search.
- Stocker l’ID de hashtag renvoyé avec le texte normalisé du hashtag.
- Associer l’ID au compte connecté et à l’heure de sa résolution.
- Utiliser l’ID pour récupérer les médias plutôt que de résoudre le même terme à répétition.
La réponse doit être traitée comme un résultat de résolution, pas comme les résultats de recherche eux-mêmes. Stockez l’identifiant renvoyé et les métadonnées de requête nécessaires à l’audit. Si l’API rejette la requête, vérifiez le type de compte connecté, les permissions, l’état du token, la version de l’API et l’état des quotas avant de modifier la logique applicative.
Une fois l’ID obtenu, appelez /{ig-hashtag-id}/top_media ou /{ig-hashtag-id}/recent_media. Choisissez l’edge selon l’objectif du produit. Les médias populaires servent une vue orientée pertinence, les médias récents une collecte sensible au temps, mais aucun des deux ne doit être présenté comme une archive mondiale complète.
Intégrez la pagination au client dès le départ. Conservez le curseur, l’horodatage de la requête, l’ID du hashtag et le statut de la réponse pour chaque page. Une fonctionnalité de recherche côté utilisateur peut charger un ensemble de résultats borné, tandis qu’un workflow d’analyse doit mettre en file des jobs de collecte et persister chaque page indépendamment, pour qu’un échec ultérieur n’efface pas une réponse déjà obtenue.
L’edge d’historique du compte, /{ig-user-id}/recently_searched_hashtags, est une capacité distincte. Il renvoie les hashtags uniques recherchés par le compte professionnel authentifié pendant la semaine en cours. Il ne révèle pas l’historique de recherche privé d’une autre personne et ne transforme pas ces termes en index général de contenu.
Types de comptes et permissions de recherche
L’erreur d’intégration la plus courante survient avant le premier appel API. Une équipe produit conçoit à partir de ce qu’une personne peut faire dans l’application grand public d’Instagram, puis suppose que le même comportement existe pour chaque utilisateur API authentifié. Le modèle d’accès officiel de Meta ne fait pas cette hypothèse.
| Contexte du compte |
Conséquence pratique pour l’API |
| Compte personnel |
Ne supposez pas qu’il peut autoriser les edges de découverte professionnels décrits par l’API Graph. |
| Compte Business |
Le contexte documenté pour la résolution de hashtags, la récupération de médias par hashtag et les workflows professionnels au niveau du compte. |
| Compte Creator |
Également pris en charge pour les workflows documentés de découverte par hashtag et liés au compte. |
La distinction importante n’est pas que les comptes Business et Creator bénéficient d’un accès illimité à la recherche. Ce n’est pas le cas. Ils accèdent à une surface limitée et soumise à permissions, qui reste encadrée par des quotas, des fenêtres temporelles, des règles d’endpoint et des politiques de plateforme versionnées. Un compte professionnel peut effectuer une requête de hashtag prise en charge, mais il ne peut pas s’en servir pour rechercher des utilisateurs publics arbitraires ni lancer des requêtes par mots-clés sans restriction.
Validez la connexion avant de construire des fonctionnalités
Votre parcours d’onboarding doit rendre l’éligibilité du compte explicite. Demandez au client de connecter l’identité Instagram qui correspond aux exigences de la fonctionnalité, validez le contexte de compte renvoyé et affichez une erreur utile lorsque le compte connecté ne peut pas effectuer l’opération demandée.
Ne cachez pas cela derrière un message générique « échec de la recherche ». Indiquez à l’utilisateur que la fonctionnalité nécessite un compte professionnel éligible, ou que le type de recherche demandé n’est pas disponible via l’API officielle. Cette explication évite aux équipes support de courir après des rafraîchissements de token quand le vrai problème est le périmètre.
L’API Basic Display de Meta a été dépréciée le 4 septembre 2024, et les requêtes ont commencé à renvoyer des erreurs le 4 décembre 2024, comme l’indique l’avis de dépréciation de l’API Basic Display. Les nouvelles intégrations de niveau professionnel doivent donc s’appuyer sur le modèle de permissions de l’API Graph Instagram plutôt que sur l’ancien accès en lecture seule au profil et aux photos.
Un modèle de permissions propre améliore aussi la sécurité. Ne demandez que l’accès dont votre fonctionnalité a besoin, gardez les tokens côté serveur et séparez la connexion du compte de l’exécution des recherches. Plus la capacité demandée est étroite, plus il est facile d’expliquer le consentement et de diagnostiquer les échecs d’autorisation.
Rate limits, quotas et fenêtres temporelles
Une intégration de recherche peut être logiquement correcte et pourtant échouer en exploitation. Meta précise que les requêtes à l’API Graph sont soumises à des rate limits dans sa documentation sur les rate limits de l’API Graph. Les workflows de recherche Instagram ajoutent leurs propres limites pratiques : un worker qui boucle sur des hashtags finira par se heurter à une contrainte de la plateforme ou par manquer des données déjà expirées.
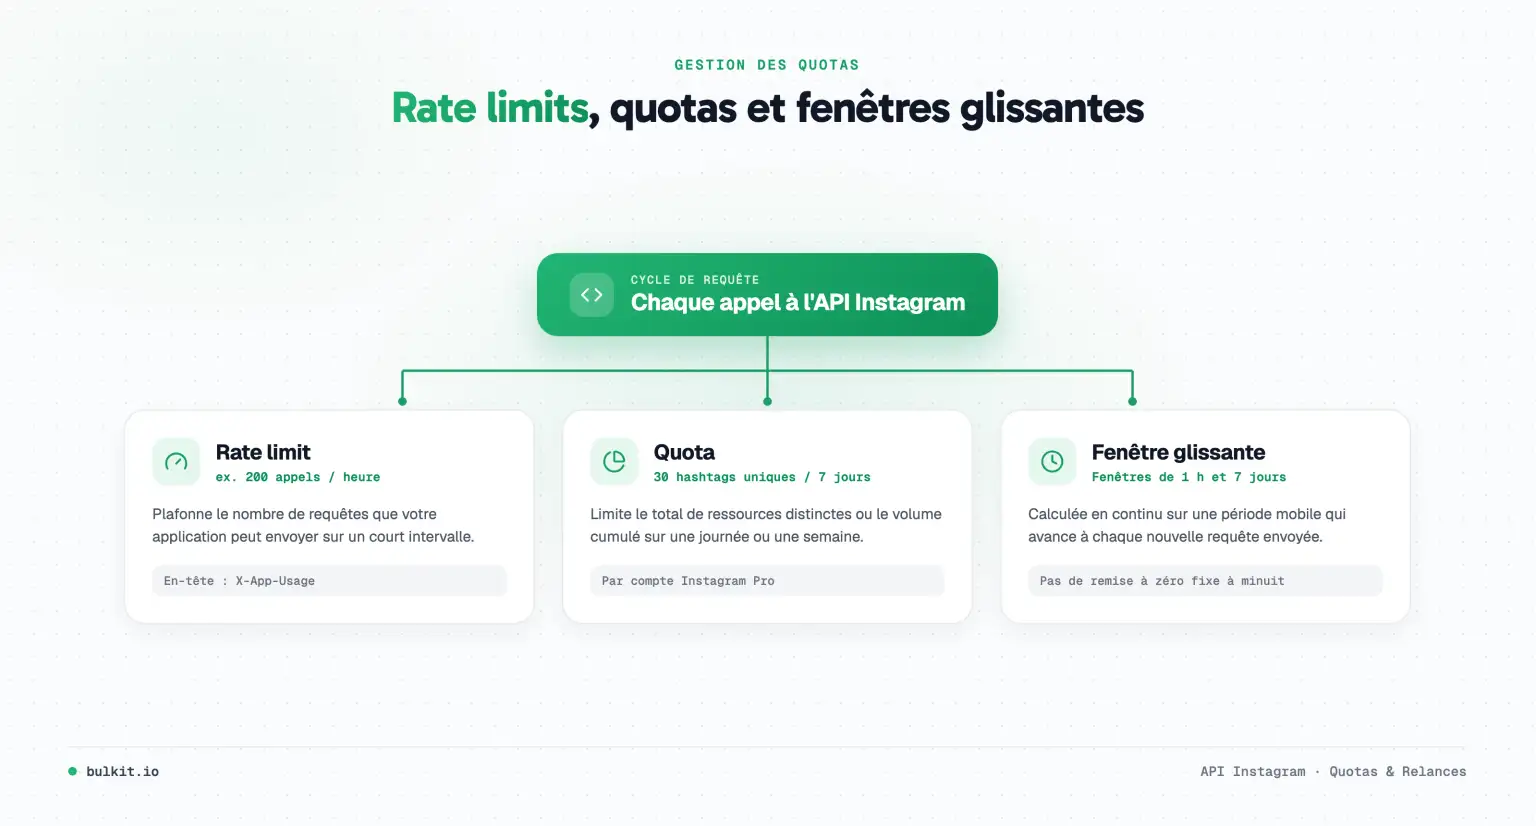
Le flux documenté de recherche de hashtags plafonne un compte Instagram Business ou Creator à 30 hashtags uniques par semaine, et l’objet utilisateur expose les hashtags recherchés sur une fenêtre rétrospective de 7 jours. Ce sont deux contraintes différentes. L’une limite le nombre d’explorations de hashtags uniques que le compte peut effectuer, l’autre la profondeur de l’historique de recherche exposé. Stockez les deux dans votre modèle d’intégration au lieu de traiter « l’accès hebdomadaire » comme une seule limite générique.
Des documentations de développeurs indépendantes citant les règles de Meta décrivent une fenêtre d’une heure pour Business Discovery et Hashtag Search, avec une formule de 200 fois le nombre d’utilisateurs. Ces mêmes synthèses distinguent ce modèle de celui des API standard de publication et d’engagement, qui utilisent un modèle distinct sur 24 heures par cas d’usage métier, lié aux impressions. N’appliquez pas une seule formule de limite à tous les endpoints Instagram.
Votre ordonnanceur doit classer les jobs par opération, par compte et par fenêtre de plateforme. Un enregistrement de file utile comprend la famille d’endpoints, le compte connecté, la prochaine heure d’exécution autorisée, le nombre de tentatives et la dernière réponse de la plateforme. Quand une réponse de limite arrive, retardez le job selon les indications renvoyées ou votre politique de backoff documentée. Relancer immédiatement ne fait que consommer davantage de capacité et rend la file plus difficile à rétablir.
La fraîcheur des données est un problème de modélisation
La récupération des médias récents peut vite devenir obsolète. Des synthèses destinées aux développeurs indiquent que la visibilité des médias récents peut expirer au bout d’environ 24 heures, que la pagination peut être plafonnée à 50 résultats par page et que les éléments renvoyés n’arrivent pas forcément dans l’ordre chronologique. Ces contraintes font d’un « rapport de recherche quotidien » une promesse fragile, à moins que le système n’enregistre l’heure de collecte et n’indique clairement que le jeu de données est partiel.
Partez d’hypothèses défensives :
- Collectez tôt : programmez la collecte au plus près du moment où votre processus métier a besoin des données.
- Persistez chaque page : enregistrez chaque page réussie plutôt que de ne conserver que l’agrégat final.
- Triez localement : utilisez les horodatages des médias renvoyés pour l’affichage, mais ne supposez pas que l’ordre de l’API est chronologique.
- Signalez les trous : consignez dans le jeu de données les pages en échec, les curseurs épuisés et les jobs ignorés.
- Évitez les reprises d’historique : ne promettez pas l’exhaustivité historique quand la source n’expose qu’une fenêtre de récupération courte et incomplète.
Les données de recherche ne constituent pas une archive durable par défaut. Votre pipeline doit conserver les réponses utiles tant qu’elles sont disponibles.
Normaliser les résultats de recherche Instagram dans un schéma unifié
Les réponses brutes de l’API sont pensées pour un accès propre à chaque endpoint, pas pour un entrepôt d’analyse multiplateforme. Une résolution de hashtag renvoie un identifiant. Un edge de médias renvoie des objets médias et des métadonnées de pagination. Un edge d’historique renvoie des valeurs de hashtags recherchés. Si le code en aval consomme directement ces réponses, chaque dashboard et chaque export devient couplé aux noms de champs d’Instagram.
Créez un enregistrement de recherche interne avec des champs stables, par exemple :
| Champ interne |
Donnée ou signification côté Instagram |
source |
instagram |
object_type |
hashtag, media ou search_history |
object_id |
ID du hashtag ou du média lorsqu’il est fourni |
query_text |
Texte normalisé du hashtag utilisé pour la résolution |
account_id |
Compte Instagram autorisé ayant effectué la requête |
observed_at |
Heure à laquelle votre service a reçu la réponse |
published_at |
Heure de publication du média lorsqu’elle est disponible |
rank_context |
top_media ou recent_media |
raw_payload_ref |
Pointeur vers un stockage brut chiffré ou à accès contrôlé |
collection_status |
Complete, partial, failed ou expired |
Séparez l’identité de la requête de l’identité de l’objet renvoyé. Un même média peut apparaître dans plusieurs jobs de collecte, et un hashtag peut être résolu plusieurs fois au fil des sessions. Une règle d’unicité composite fondée sur la source, le compte, le type d’objet, l’ID de l’objet et le contexte de collecte évite les doublons accidentels sans prétendre que chaque réponse est un instantané permanent.
Conservez la provenance et l’incertitude
Stockez l’endpoint utilisé, l’heure de la requête, l’heure de la réponse, le curseur et le contexte de permissions. Ces champs permettent aux analystes de répondre plus tard à des questions simples : l’élément était-il absent, ou le worker a-t-il échoué ? Le résultat a-t-il été collecté via les médias populaires ou les médias récents ? Le compte a-t-il changé entre deux requêtes ?
Ne réduisez pas les champs manquants à des valeurs fausses. Un horodatage manquant n’équivaut pas à un horodatage à zéro, et une page vide ne prouve pas l’absence de contenu pertinent. Représentez séparément les états inconnu, indisponible et vide, pour que vos rapports ne transforment pas les limites de l’API en conclusions trompeuses.
Normalisez les hashtags pour la correspondance, mais conservez la valeur d’affichage d’origine pour la présentation. Gardez les réponses brutes sous accès contrôlé, appliquez une politique de conservation et rendez la suppression possible quand un compte connecté se déconnecte. Un schéma normalisé doit simplifier l’analyse sans inciter l’équipe à stocker plus de données utilisateur que la fonctionnalité n’en exige.
Concevoir des pipelines de recherche fiables
Un script qui résout un hashtag et affiche une réponse prouve que l’authentification fonctionne. Il ne prouve pas que vous êtes prêt pour la production. Les jobs de recherche ont besoin d’ordonnancement, de persistance, de nouvelles tentatives, de validation et d’un moyen explicite de signaler aux opérateurs que la source a renvoyé une vue partielle.
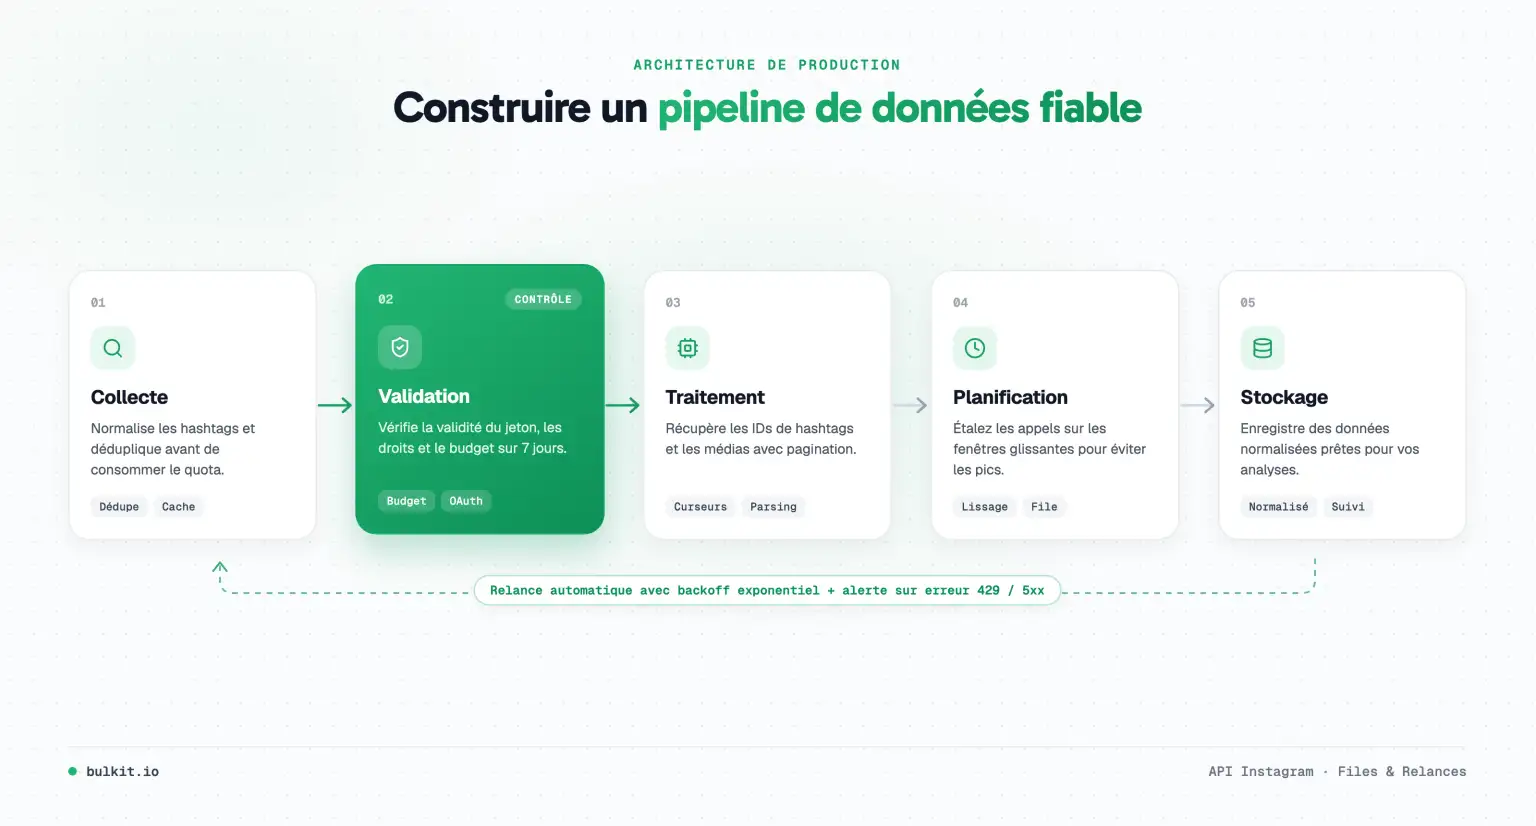
Une conception durable sépare la découverte de l’ingestion. Le service de découverte accepte une requête de hashtag autorisée et enregistre l’ID résolu. Une file programme ensuite la collecte des médias populaires ou récents, tandis que des workers récupèrent les pages, valident les réponses et écrivent des enregistrements idempotents. Un registre d’état distinct indique si le job s’est terminé, s’est heurté à une limite de la plateforme ou s’est arrêté après un échec d’autorisation.
Chaque job doit porter son contexte de compte et son type d’opération. L’ordonnanceur peut ainsi appliquer le bon délai d’attente au lieu de traiter tous les échecs comme transitoires. Relancez les timeouts réseau et les erreurs serveur temporaires, mais orientez les permissions invalides, les types de comptes non pris en charge et les edges indisponibles vers un état d’échec visible qui exige une correction.
La validation doit intervenir avant la persistance :
- Contrôle d’identité : vérifier que la réponse correspond au hashtag ou au contexte de compte demandé.
- Contrôle de pagination : enregistrer le curseur et détecter les curseurs répétés pour éviter les boucles.
- Contrôle d’horodatage : enregistrer l’heure d’observation séparément de l’heure de publication du média.
- Contrôle des doublons : faire un upsert par identité d’objet stable et conserver la provenance de la collecte.
- Contrôle d’exhaustivité : marquer le job comme partiel si une page échoue ou si la fenêtre de la source se ferme.
Ne laissez pas les nouvelles tentatives écraser les réponses précédentes. Stockez les tentatives et leurs résultats, puis exposez le dernier jeu de données exploitable accompagné d’un avertissement opérationnel. Les analystes peuvent travailler avec une collecte partielle s’ils savent qu’elle l’est. Ils ne peuvent pas prendre une bonne décision à partir d’un rapport qui semble complet alors que des pages ont été perdues.
Une couche de monitoring doit suivre l’âge des files, les échecs d’autorisation, les réponses de rate limit, les curseurs répétés et les jobs de collecte obsolètes. Les alertes doivent identifier le compte connecté et la famille d’endpoints, pas simplement dire « erreur Instagram ».
Pour les équipes qui évaluent des couches d’abstraction, comparez si le service expose l’état des jobs, le comportement de backoff, l’accès aux réponses brutes et des diagnostics par compte. Le comparatif avec Ayrshare est une référence utile pour l’évaluation produit, mais le test technique reste le même : votre système peut-il expliquer ce qu’il a collecté, ce qu’il a manqué et pourquoi ?
Intégrer Bulkit pour une gestion unifiée des réseaux sociaux
Les équipes qui construisent un produit multiréseau découvrent souvent que la recherche Instagram n’est qu’une partie de la charge de maintenance. Les connexions OAuth, la gestion du cycle de vie des tokens, les changements de version, les schémas propres à chaque plateforme, les nouvelles tentatives et le backoff sur les rate limits peuvent consommer plus de temps d’ingénierie que l’intégration initiale de l’endpoint. Une couche unifiée a de la valeur lorsqu’elle préserve la visibilité opérationnelle au lieu de masquer les contraintes de la plateforme derrière une réponse de succès générique.
Bulkit propose une interface REST cohérente pour la publication, la programmation, les commentaires et les statistiques sur les principaux réseaux, avec des SDK et des outils de workflow construits autour du même modèle d’API. Ses capacités publiées incluent les connexions OAuth via des applications de plateforme approuvées, le rafraîchissement des tokens, des webhooks, un dashboard, une CLI, un nœud n8n et un serveur MCP. Ces briques prennent en charge le travail d’intégration périphérique, tandis que le périmètre de recherche propre à Instagram détermine toujours la découverte autorisée.
Comparez les modèles de maintenance
Avec une intégration directe à l’API Graph, votre équipe gère :
- L’onboarding des comptes et le diagnostic des permissions.
- Le stockage, le rafraîchissement et la déconnexion des tokens.
- Les changements de version des endpoints et la normalisation des réponses.
- L’ordonnancement des files, les nouvelles tentatives et le backoff de la plateforme.
- Les abstractions multiréseaux quand le produit ajoute un autre canal.
Avec une API de réseaux sociaux gérée, le fournisseur prend en charge une plus grande partie de cette plomberie, et votre application consomme un modèle de requêtes et de données cohérent. Ce compromis peut accélérer la livraison, mais il rend aussi la transparence du fournisseur importante. Vérifiez comment le service expose les opérations non prises en charge, les résultats partiels, l’éligibilité des comptes et les erreurs de plateforme.
L’API REST, le SDK TypeScript/Node.js, la CLI, le serveur MCP, le nœud n8n et les webhooks de Bulkit s’adressent aux équipes qui veulent une seule surface d’intégration pour leurs workflows sur les réseaux sociaux. Pour une fonctionnalité de recherche Instagram, la vraie question n’est pas de savoir si une abstraction peut créer un endpoint de recherche universel. Elle ne peut pas modifier le périmètre autorisé par Meta. La question est de savoir si elle peut réduire l’infrastructure répétitive de comptes et de workflows autour du cas d’usage pris en charge, tout en gardant les limites visibles.
Optez pour une intégration directe lorsque le contrôle spécifique à Instagram et le comportement au niveau de l’endpoint sont des exigences centrales du produit. Envisagez un service unifié lorsque votre feuille de route comprend plusieurs réseaux sociaux et que votre équipe préfère maintenir un seul modèle opérationnel plutôt que plusieurs SDK de plateformes.
Check-list de l’intégration de la recherche Instagram
Utilisez cette matrice des défaillances avant la mise en production :
| Défaillance |
Détection |
Réponse |
| Quota dépassé |
Les requêtes commencent à renvoyer des erreurs de rate limit |
Mettez la file en pause, appliquez un backoff exponentiel et consignez la fenêtre de nouvelle tentative. Consultez la documentation sur les rate limits de l’API Graph avant d’augmenter le débit. |
| Token expiré |
L’authentification échoue systématiquement |
Marquez la connexion comme inactive et demandez une nouvelle autorisation. |
| Compte non éligible |
Les erreurs de permission ou de type de compte persistent |
Affichez une erreur de configuration claire au lieu de relancer. |
| Résultats obsolètes |
Les horodatages ou les curseurs n’avancent plus |
Marquez le job comme incomplet et évitez de le présenter comme une archive. |
Persistez les ID de requête, les curseurs, les horodatages, les noms d’endpoints et le statut des jobs partiels. Ces champs permettent aux opérateurs de distinguer les limites de la plateforme des défauts d’intégration, et d’expliquer aux utilisateurs pourquoi des résultats manquent.
Bulkit fournit des requêtes REST unifiées, des SDK, des outils de workflow, la gestion OAuth et des webhooks pour les opérations multiréseaux. Évaluez Bulkit si réduire la maintenance propre à chaque plateforme compte pour vous.