Qu’est devenu Facebook Graph Search ?
Le Graph Search d’origine a changé la façon de concevoir la recherche sur Facebook. Avant lui, les utilisateurs raisonnaient en recherche par mots-clés, comme pour chercher un titre de Page ou le texte d’une publication. Graph Search a orienté la plateforme vers une découverte sémantique à travers les relations et les contenus partagés : une requête pouvait parcourir des personnes, des photos, des lieux, des centres d’intérêt et les connexions entre eux TechCrunch sur le lancement de 2013.
C’était important, car l’objet de la recherche n’était pas un corpus de documents au sens habituel du web. C’était un graphe social, rempli d’identifications, de légendes, de check-ins, de commentaires et de connexions qui rendaient le contenu repérable par les relations plutôt que par le texte brut. Pour les utilisateurs, cette découverte en langage quasi naturel semblait magique. Pour les ingénieurs de la plateforme, elle a presque immédiatement ouvert une immense surface d’exposition de la vie privée CBC sur les inquiétudes liées à Graph Search.
Le produit grand public et l’API ne sont pas la même chose
Beaucoup de développeurs confondent encore l’ancien produit grand public et la Graph API actuelle. C’est le mauvais modèle mental. Graph Search était une expérience de recherche, tandis que la Graph API est une interface programmatique donnant accès à des objets et des permissions précis, avec une recherche limitée par ce que Meta expose et par ce que l’utilisateur ou l’application a le droit de voir.
Cette distinction compte, car l’ancienne interface laissait entendre une découverte large, alors que l’accès moderne est sélectif. Vous ne pouvez pas traiter la Graph API comme un moteur de requêtes magique sur l’ensemble du réseau. Vous travaillez à l’intérieur de limites de visibilité explicites, et la fonctionnalité n’a historiquement disposé d’aucune API dédiée permettant d’exploiter cette ancienne expérience de recherche dans un workflow métier général HuffPost sur l’absence d’API dédiée.
Règle pratique : si une requête vous semble devoir fonctionner parce qu’elle fonctionnait dans l’ancienne barre de recherche, partez du principe qu’elle ne survivra probablement pas telle quelle au modèle de permissions actuel.
En 2026, la meilleure façon de penser la recherche dans le graphe Facebook est la suivante. Le produit d’origine visait une large découverte grand public. Ce qui reste aux développeurs, c’est la récupération ciblée d’objets autorisés, pas l’exploration illimitée de tout le graphe. C’est pourquoi la conception commence par le type d’objet, le périmètre et la visibilité, et non par l’ingéniosité de la requête.
L’architecture d’une recherche dans un graphe social diffère de celle d’un robot d’indexation web. Un moteur comme Google indexe des pages qui sont, pour l’essentiel, des documents autonomes. Un système de graphe social doit indexer des relations, des edges et des entités qu’on peut parcourir dans plusieurs directions, souvent sous des contrôles de visibilité stricts. C’est pourquoi le système Unicorn de Meta est décrit comme une couche de recherche en ligne et en mémoire sur le graphe social, qui indexe des milliers de milliards d’edges couvrant des dizaines de milliards d’utilisateurs et d’entités sur des milliers de serveurs standard, et répond à des milliards de requêtes par jour avec des latences de quelques centaines de millisecondes publication de Meta Research sur Unicorn.
Cette conception en dit long sur ce qui fonctionne en pratique. La récupération dans le graphe repose sur un sharding agressif, un accès en mémoire et une indexation adaptée au graphe. Cette combinaison est puissante, mais elle ne pardonne rien. Quand vous demandez un parcours large et sans contrainte, le système doit inspecter très vite d’immenses surfaces relationnelles, et c’est pour cela que la sémantique de recherche est étroitement encadrée plutôt que laissée ouverte.
Pourquoi c’est important pour les développeurs
Si vous construisez une recherche sur un graphe social, vous ne demandez pas seulement « cet objet existe-t-il ? ». Vous demandez « puis-je atteindre cet objet par ce chemin relationnel, avec ce jeu de permissions, assez vite pour renvoyer une réponse exploitable ? ». C’est un problème très différent. La réponse dépend souvent davantage de la conception de l’index et de la politique d’accès que du texte de la requête.
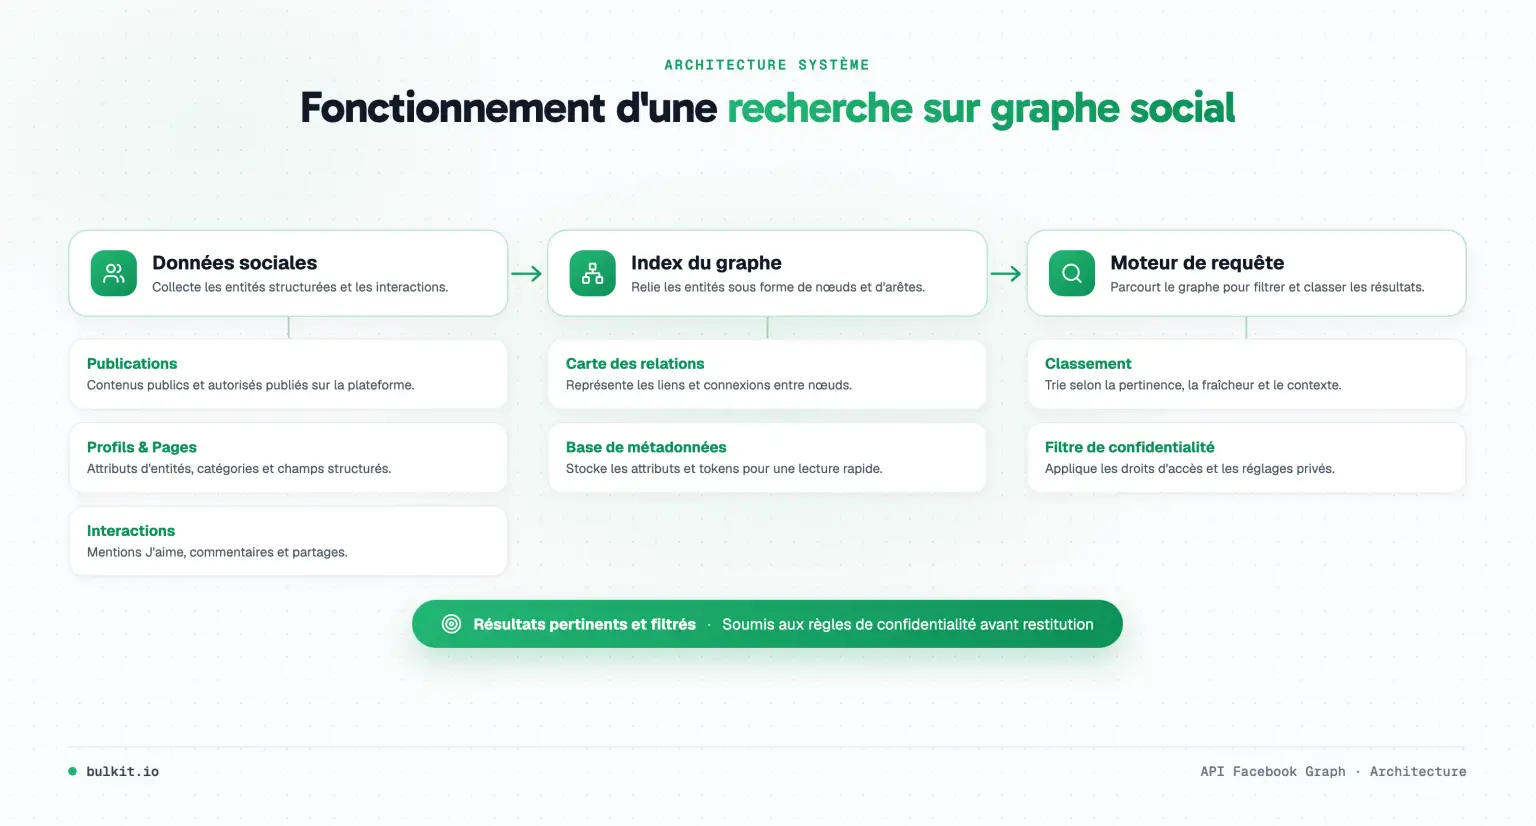
La conséquence pratique est simple. Certaines formes de requêtes sont efficaces parce qu’elles correspondent à la façon dont le graphe est stocké et partitionné. D’autres deviennent coûteuses, bruitées ou incomplètes parce qu’elles exigent de parcourir une trop grande partie du graphe ou de franchir des limites de visibilité que la couche de requêtes ne peut pas contourner. C’est pourquoi architecture et conception produit sont ici indissociables. La forme du système détermine les expériences de recherche que vous pouvez promettre.
Les systèmes de recherche sociale les plus rapides n’essaient pas d’être malins au moment de la requête. Ils décident à l’avance de ce qui est indexable, de ce qui est visible et de ce qui peut être classé sans faire exploser la latence.
Ce compromis explique pourquoi la recherche dans un graphe à l’échelle du grand public paraît fluide quand elle fonctionne, mais fragile dès qu’on essaie d’en faire une brique générique pour les développeurs. Le matériel peut être rapide. La sémantique, elle, reste stricte.
Indexation par tokens et correspondance des requêtes
Une erreur fréquente consiste à supposer que la recherche Facebook se comporte comme la recherche d’expressions d’un moteur classique. Ce n’est pas le cas. La documentation développeur de Meta indique que le contenu est enregistré dans un index construit à partir de tokens extraits des champs texte, et que les requêtes sont comparées à ces tokens par correspondance exacte de tokens au moment de la requête documentation développeur de Meta sur la qualité de recherche. L’ordre des mots n’est donc pas le principal facteur de rappel.
C’est plus important que beaucoup d’équipes ne le pensent. Si votre requête contient les bons mots, mais dans un autre ordre, le système peut tout de même renvoyer des correspondances équivalentes, car il compare les tokens indépendamment au lieu de traiter l’expression comme une chaîne indivisible. Concrètement, l’index se soucie davantage des termes présents que de la formulation exacte que vous avez saisie.
Ce que change la correspondance par tokens
L’indexation par tokens reporte la charge sur la normalisation, la gestion des locales et le classement. Si votre contenu comprend des noms composés, du texte multilingue ou une ponctuation propre à une locale, la tokenisation peut découper ou normaliser l’entrée d’une manière qui modifie les correspondances. Ce n’est pas un bug de la couche de recherche : c’est son mécanisme.
Cela signifie aussi que les développeurs ne peuvent pas compter sur la correspondance d’expressions pour la précision. Une requête qui semble précise peut renvoyer des résultats plus larges si ses tokens sont assez courants. À l’inverse, une requête qui paraît naturelle à un humain peut échouer si la tokenisation découpe le champ de façon inattendue. C’est l’une des raisons pour lesquelles la recherche dans un graphe social semble moins déterministe qu’un filtrage en base de données.
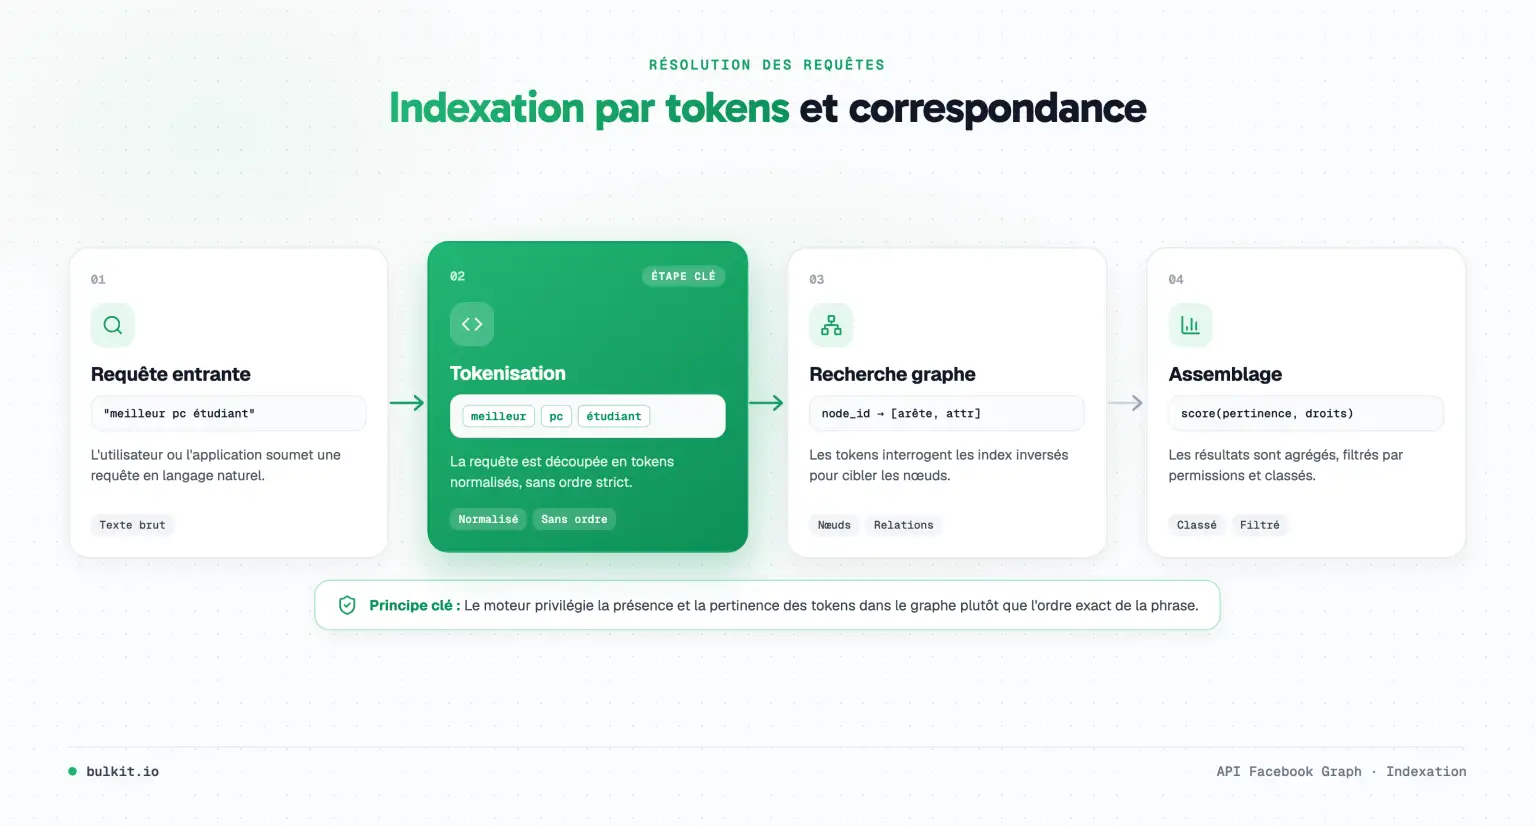
À retenir côté ingénierie : écrivez votre logique de recherche en considérant que l’ordre aide au classement, mais n’est pas requis pour la correspondance. Si vous avez besoin d’une sémantique d’expression stricte, ajoutez votre propre filtrage après la récupération, car le pipeline sous-jacent raisonne d’abord en tokens.
Cette limite passe facilement inaperçue quand la documentation montre des exemples réussis. Ces exemples paraissent propres parce que les données le sont. Le contenu réel ne l’est pas. Les utilisateurs écrivent des libellés incohérents, publient dans différentes langues et omettent des champs clés. La correspondance par tokens rend ce désordre interrogeable, mais elle rend aussi l’exactitude plus difficile à garantir.
Endpoints et requêtes de recherche de la Graph API en pratique
Le chemin moderne pour les développeurs n’est pas une grande barre Graph Search : c’est l’endpoint /search de la Graph API, avec un type d’objet précis. En pratique, vous choisissez d’abord la classe d’objet, puis vous ajustez les champs de la requête autour d’elle. C’est une façon de travailler plus rigoureuse, et la seule qui permet de rester dans le modèle de permissions de la plateforme.
Un schéma simple ressemble à ceci :
GET /search?type=page&q=coffee
Ce type de requête sert à découvrir des Pages par mot-clé. Pour les lieux, les groupes, les utilisateurs ou les événements, la forme change, mais la logique reste la même. Vous choisissez le type d’objet interrogeable, fournissez le terme de recherche, puis affinez les résultats par un filtrage complémentaire si nécessaire. La recherche ne remplace pas la récupération d’objets : c’en est la porte d’entrée.
Dans les vrais systèmes, le travail intéressant commence après la recherche initiale. Il faut souvent combiner une requête par mot-clé avec un filtrage par lieu, par catégorie ou des vérifications de permissions dans la couche applicative. C’est là que les attentes des développeurs s’écartent de la réalité de la plateforme. L’API peut renvoyer des candidats, mais votre application doit encore décider lesquels sont exploitables.
| Comparatif des endpoints de recherche de la Graph API |
|
|
|
| Type de recherche |
Permission requise |
Cas d’usage type |
Limites des résultats |
| Page |
Permissions de l’application et de l’utilisateur couvrant le périmètre de l’objet |
Découverte de marques, d’entreprises ou de communautés |
Uniquement les objets visibles dans le périmètre autorisé |
| Lieu |
Accès lié à la localisation, le cas échéant |
Recherche de lieux ou de magasins |
Peut être restreint par localisation et manquer malgré tout des entrées privées ou restreintes |
| Groupe |
Accès régi par la visibilité du groupe et les permissions de l’application |
Découverte de communautés et outils de modération |
Les groupes privés et le contenu restreint n’apparaissent pas largement |
| Utilisateur |
Limites strictes de permissions utilisateur |
Recherche d’identité limitée dans des contextes approuvés |
Fortement contraint par la confidentialité et l’accès de l’application |
| Événement |
Dépend de la visibilité et des permissions |
Découverte d’événements publics |
Les événements privés ou sur invitation restent masqués |
À quoi cela ressemble-t-il en production ? Vous commencez par la plus petite requête susceptible de fonctionner. Puis vous vérifiez si des résultats vides viennent d’un mauvais choix de tokens, d’une visibilité insuffisante ou d’une permission manquante. Cet ordre de débogage compte, car il vous évite de prendre un filtrage de confidentialité pour un échec d’indexation.
Si vous construisez autour de la recherche, l’endpoint n’est que la moitié de l’histoire. L’autre moitié, c’est le traitement des réponses. Les jeux de résultats sont souvent partiels, et c’est normal. Un bon client traite la recherche comme une génération de candidats, pas comme une vérité.
Les contraintes de confidentialité qui cassent vos requêtes
La raison la plus fréquente pour laquelle une recherche via la Graph API ne renvoie rien, c’est que la confidentialité fait son travail. Les évolutions de Graph Search ont rendu plus difficile le masquage d’un journal entier dans les résultats de recherche, tandis que des éléments individuels pouvaient toujours être protégés par des paramètres de confidentialité plus stricts, élément par élément. Cette séparation détermine encore ce que les développeurs peuvent voir ou non CBC sur les changements de confidentialité de 2013.
Seul le contenu public ou autorisé apparaît dans les flux de recherche modernes. Si l’utilisateur n’a pas accordé à votre application l’accès nécessaire, ou si le contenu est protégé par une confidentialité au niveau de l’élément, votre requête peut être syntaxiquement correcte et renvoyer malgré tout une liste vide. L’API refuse de divulguer des données que vous n’avez pas le droit de consulter.
Ce qui casse les hypothèses en production
Les développeurs le remarquent généralement d’abord quand la préproduction et la production se comportent différemment. Les comptes de test contiennent souvent des données rares et maîtrisées. Les vrais utilisateurs ont des paramètres de confidentialité variés, des permissions inégales et du contenu dispersé entre plusieurs types d’objets. La qualité de recherche semble se dégrader, mais le vrai problème, c’est que votre échantillon n’a jamais été représentatif.
Les filtres de confidentialité doivent être traités comme une source à part entière de résultats vides, pas comme un cas limite.
Vous devez en tenir compte dès le départ. Affichez des messages indiquant que les résultats sont partiels. Évitez d’affirmer qu’un enregistrement manquant signifie un objet inexistant. Si votre workflow dépend d’une découverte complète, prévoyez des solutions de repli explicites et prévenez les utilisateurs qu’une partie du contenu peut être masquée par les règles de visibilité. La bonne expérience utilisateur est honnête sur le périmètre au lieu de prétendre que l’API est exhaustive.
Une check-list pratique pour l’UX de recherche est simple :
- Soyez explicite sur le périmètre. Indiquez aux utilisateurs si vous cherchez dans des Pages publiques, des lieux ou du contenu lié aux permissions accordées.
- Gérez les correspondances partielles avec élégance. Ne faites pas échouer tout le flux parce qu’un type d’objet est revenu vide.
- Distinguez « aucun résultat » et « aucun accès ». Ce sont deux issues différentes, et les utilisateurs ne devraient pas avoir à deviner laquelle s’est produite.
- Documentez les limites de visibilité. Si du contenu peut être masqué, dites-le dans l’interface avant que les utilisateurs n’en dépendent.
Pour les équipes qui ont besoin d’un socle clair en matière de confidentialité, la politique et les exigences produit doivent être revues avant la conception de la fonctionnalité, pas après. Un bon point de départ est la présentation de la confidentialité chez Bulkit, qui rappelle que les limites de permissions doivent faire partie du plan d’ingénierie, et non devenir un problème de support en fin de parcours.
La controverse autour de l’ancien Graph Search l’a rendu évident il y a des années. Les gens ne s’inquiétaient pas seulement de l’accès : ils s’inquiétaient de la découvrabilité elle-même, car la recherche faisait ressortir plus facilement des statuts, des légendes, des check-ins et des commentaires difficiles à trouver jusque-là. La même leçon s’applique à la conception d’applications modernes. Si du contenu peut être masqué, votre couche de recherche doit respecter ce fait tout en se comportant de façon prévisible.
La dépréciation de 2019 et ce qu’il en reste aujourd’hui
En 2019, Meta avait déjà mis en pause certaines parties de Graph Search, et la fonctionnalité était passée du statut de produit actif à celui de capacité héritée, associée à des divulgations non souhaitées et à des usages d’investigation sur le contenu du réseau VICE sur le tournant de 2019. C’est la ligne que les développeurs doivent garder en tête. Le modèle de découverte grand public d’origine n’est pas celui sur lequel reposent les intégrations modernes.
Ce qui reste est plus étroit et plus opérationnel. La Graph API expose toujours un accès de type recherche pour certaines catégories d’objets, mais le périmètre pratique se rapproche davantage des Pages, des lieux et des groupes que de la vaste vision de recherche de 2013. La surface existe toujours. La promesse qui l’accompagnait, non. Et comme la fonctionnalité n’a jamais eu de chemin d’API propre et dédié, ce n’était pas une brique métier simple au départ HuffPost sur les limites opérationnelles.
Si votre cas d’usage est la découverte d’entités publiques, la recherche via la Graph API peut encore être utile. Si vous avez besoin d’une investigation sociale plus poussée sur des personnes, des publications ou des relations cachées, la plateforme ne vous le fournira pas de façon fiable, et vous devriez prévoir une autre source de données ou une conception produit différente.
La répartition pratique est simple. Une voie consiste à rechercher des objets approuvés sous contraintes de visibilité. L’autre tente de recréer l’ancienne expérience de recherche sémantique, et c’est là que les équipes se heurtent à des frictions avec les politiques, à des résultats vides et à des coûts de maintenance. La première voie peut être livrée. La seconde s’enlise généralement.
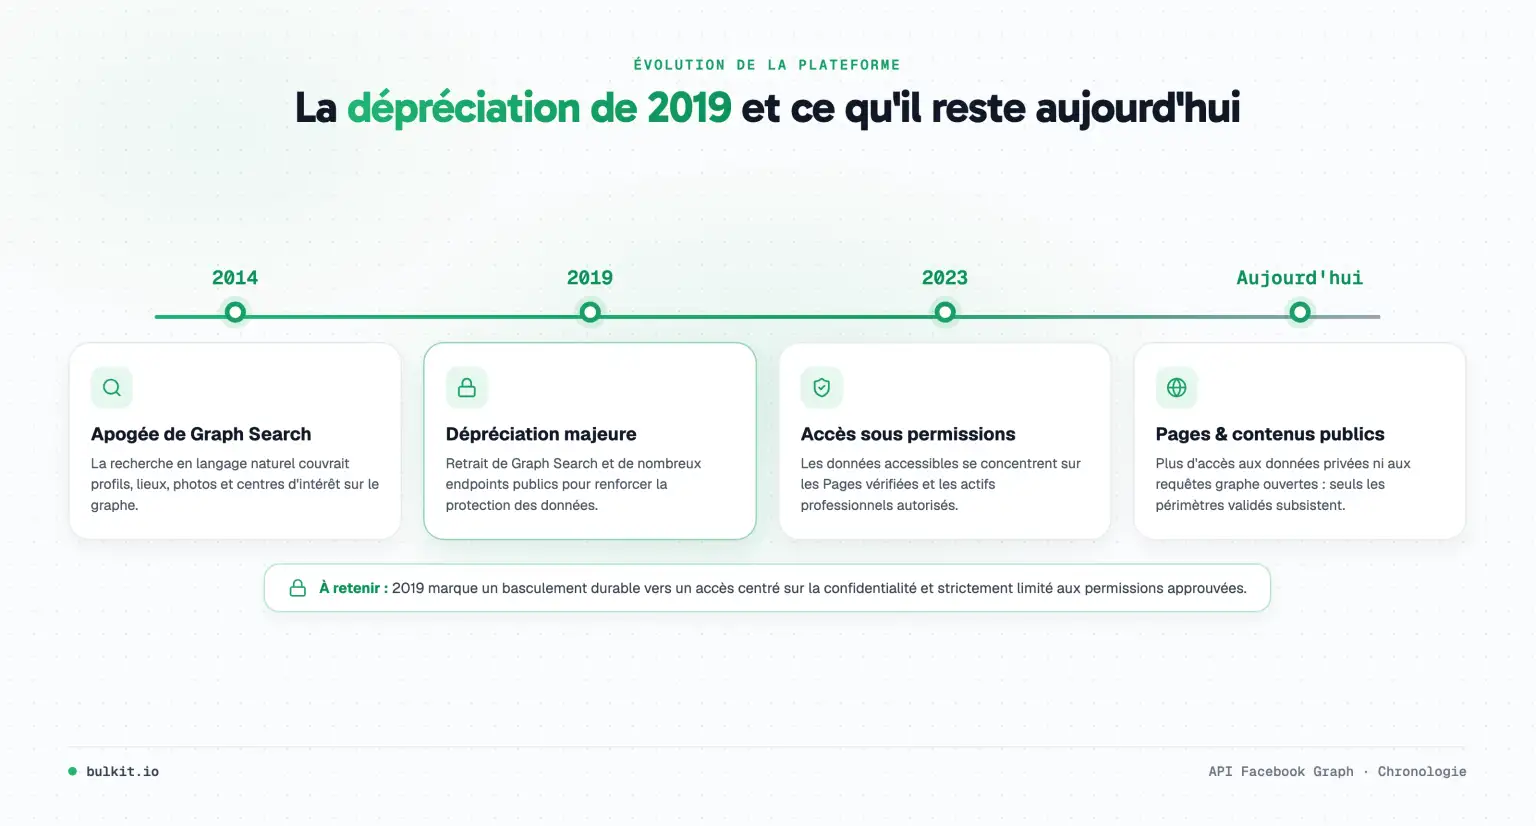
Vous devez aussi tenir compte des évolutions du cycle de vie. Meta continue de publier des mises à jour de version et des dépréciations de la Graph API : tout ce que vous construisez doit donc tolérer des changements de champs, de permissions et de disponibilité au lieu de supposer un comportement stable. Le changelog de la Graph API est le type de source que les équipes devraient surveiller. La recherche rend ces changements plus difficiles à déboguer, car des champs manquants ressemblent souvent à des données vides plutôt qu’à une rupture évidente.
Les limites de permissions comptent autant que le choix de l’endpoint. Si votre revue interne s’appuie sur un glossaire partagé, alignez les termes produit sur les conditions générales de Bulkit avant d’intégrer la recherche au workflow.
La règle la plus sûre est simple. Considérez la recherche Facebook moderne comme une couche de récupération contrainte, pas comme un moteur de recherche social public.
Construire des fonctionnalités de recherche sociale qui fonctionnent
Les équipes qui livrent des fonctionnalités de recherche sociale fiables ne courent pas après la promesse de l’ancien Graph Search. Elles conçoivent dès le premier jour pour une visibilité limitée, une correspondance par tokens et des résultats incomplets. La recherche ne sert alors qu’à générer des candidats ; le filtrage côté application, le cache et les explications destinées aux utilisateurs font le reste.
Une bonne implémentation présente généralement trois caractéristiques. D’abord, elle pose la requête la plus étroite possible et ne dépend pas de l’ordre des mots. Ensuite, elle se dégrade proprement quand les règles de confidentialité retirent du contenu. Enfin, elle combine la recherche via la Graph API avec d’autres sources quand la plateforme ne peut pas fournir seule une découverte complète. Selon le cas d’usage, il peut s’agir de bases de données internes, de jeux de données tiers approuvés ou d’outils sociaux distincts.
Un modèle d’implémentation pratique
Commencez par mettre en cache les requêtes fréquentes qui peuvent être réutilisées sans risque, surtout si votre application recherche régulièrement les mêmes objets publics. Ajoutez ensuite une divulgation progressive dans l’interface, pour que les utilisateurs puissent affiner leurs termes de recherche quand les premiers résultats sont maigres.
Traitez aussi la recherche comme un choix produit, et pas seulement comme un choix d’endpoint. Un comparatif de plateformes comme la page de comparatifs de Bulkit aide les équipes à décider si elles veulent un modèle d’intégration unique pour tous les réseaux ou des chemins de code distincts pour chacun. Ce compromis compte, car c’est généralement dans la couche de recherche que les lacunes de permissions et les coûts de maintenance apparaissent en premier.
Règle de conception : construisez votre recherche sociale pour que l’utilisateur obtienne une réponse utile même quand le graphe ne renvoie qu’une partie de la vérité.
Cette règle compte d’autant plus que la plateforme évolue. Meta s’oriente vers des contrôles plus stricts, pas plus souples. La meilleure architecture est celle qui échoue proprement quand la plateforme dit non, et qui garde le reste du workflow compréhensible.
Si vous préparez une fonctionnalité sociale, notez les objets dont vous avez besoin, la visibilité que vous pouvez accepter et la solution de repli en cas de résultats manquants. Implémentez ensuite la plus petite requête capable de soutenir cette conception. Pour les équipes qui veulent une API unifiée, des SDK, des webhooks et un modèle de données cohérent, Bulkit est une option pour réduire la quantité de plomberie de recherche à maintenir pour chaque plateforme.